AI self-hosted: Revolut molla Claude e spende un decimo
Revolut ha messo l’AI self-hosted al posto di Claude Code e Codex per 2.000 ingegneri e dice di spendere circa un decimo. Il caso, i numeri da leggere con cautela e la corsa verso l’AI indipendente.
L’AI self-hosted è passata in un anno da esperimento a voce di bilancio. Revolut, la fintech britannica, ha messo modelli aperti sui propri server come strumento predefinito per circa 2.000 ingegneri e dice di aver tagliato di circa il 90% i costi dell’AI per scrivere codice, lasciando Claude Code e Codex come eccezione. Il titolo di The Register parla di “10x”. Vedremo che il numero va letto con un po’ di prudenza, ma la direzione è chiarissima e riguarda qualcosa di più dei soldi: quanto vi conviene dipendere da un solo fornitore per una tecnologia che sta diventando il motore di tutto il resto.
Cosa ha fatto Revolut
A raccontarlo è David Abitbol, che guida operazioni e infrastruttura AI in Revolut, durante la conferenza AI Engineer di New York, a metà ottobre 2026. Revolut ha cominciato ad aprile a ospitare in casa i modelli GLM di Z.ai, sviluppatore cinese: prima GLM-5.1 (754 miliardi di parametri, di cui 40 attivi per ogni token), poi GLM-5.3, serviti oggi da 56 GPU Nvidia B200, l’equivalente di sette sistemi DGX.
Il costo dichiarato è di circa 0,30 dollari per milione di token, più o meno un decimo di Codex e Claude Code. Prima del cambio gli ingegneri arrivavano a spendere tra 1.000 e 10.000 dollari al mese con un ritorno scarso, tanto che l’azienda aveva dovuto imporre limiti di budget severi. Sul fronte prestazioni, il tempo al primo token resta sotto i 3 secondi con 256.000 token di contesto: oltre i 5 secondi, racconta Abitbol, partono le lamentele.
Token illimitati, abitudini diverse
La parte più interessante non è il risparmio, è cosa succede quando smettete di razionare. Con i token a buon mercato e la fatturazione prevedibile, niente più sorprese a fine mese, gli ingegneri hanno cominciato a usare l’AI anche per il debugging e per i ticket di Jira e Confluence, non solo per scrivere codice. Secondo Revolut i guadagni maggiori sono arrivati proprio da lì: -60% nei tempi di scrittura del codice e -70% nei lead time, dati interni dell’azienda.
Non è un addio a Claude
Il titolo suggerisce una rottura netta, la realtà è un’architettura mista. GLM è solo testo, quindi le richieste con immagini e interfacce vengono smistate da un router verso modelli come Gemini o GPT. Claude Code e Codex restano disponibili per i casi specialistici: per Abitbol la frontiera è “l’eccezione”, non la regola. Ecco, indipendenti sì, ma di default, non per forza.
Non è solo Revolut
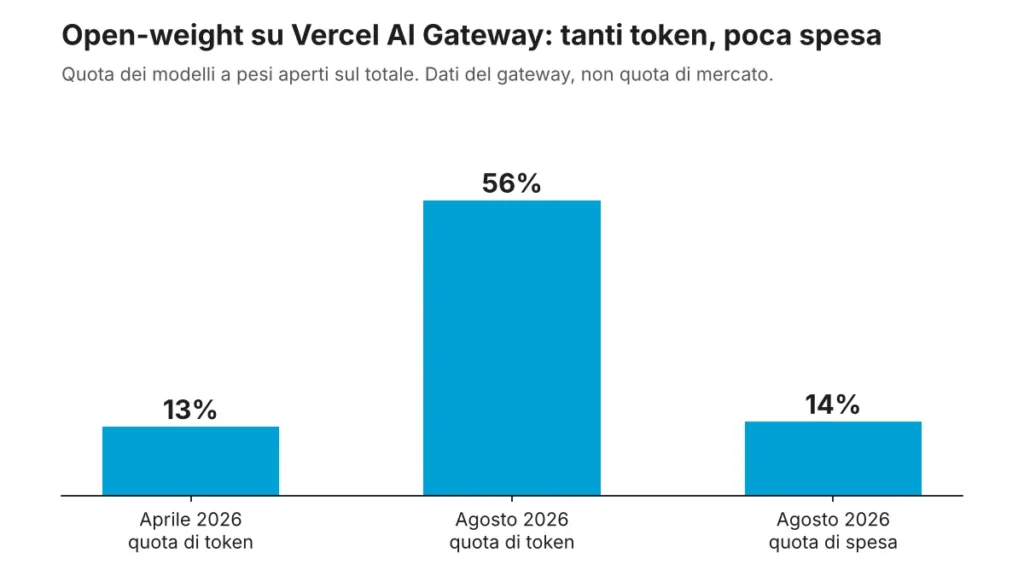
Il movimento è largo, anche se i numeri dipendono da cosa si misura. A inizio mese Wall Street ha tremato proprio sulle azioni AI, e quanto costa davvero usare l’AI è diventata una domanda da bilancio. Su Vercel AI Gateway i modelli a pesi aperti sono passati dal 13% dei token di aprile 2026 al 56% di agosto, ma pesano solo per il 14% della spesa stimata (dati Futurum).
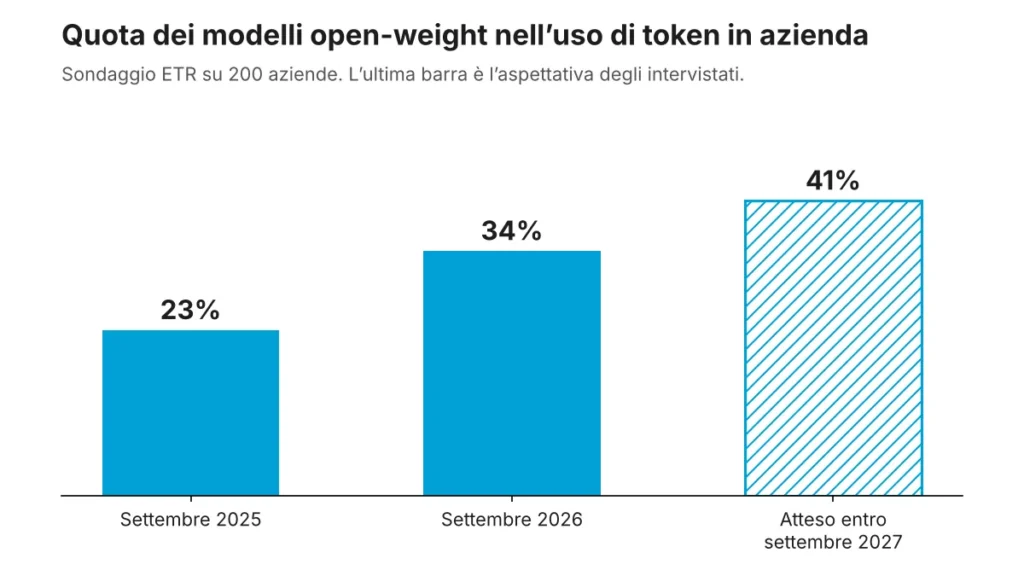
Un sondaggio ETR di settembre su 200 aziende dà i modelli open-weight al 34% dell’uso di token in azienda, contro il 23% di un anno prima, con il 41% atteso entro dodici mesi.
AT&T ha raccontato a luglio un gateway che smista ogni richiesta al modello più adatto, con 45 miliardi di token al giorno e costi ridotti fino all’80%. Secondo il Financial Times, aziende come Tinder, PNC, CH Robinson e Siemens stanno valutando modelli aperti, e Tinder ha cominciato a dirottarci alcune richieste dei dipendenti non tecnici.
Tuttavia, c’è il rovescio. Per Futurum i modelli aperti pesano appena il 5% della spesa AI misurata, contro il 36% di Microsoft 365 Copilot e il 29% di Claude (ma il self-hosting non genera fatture di un fornitore, quindi il dato sottostima). E secondo Ramp, solo il 6,4% delle aziende che spendono in AI paga per modelli open source: gran parte dello spostamento è andato su modelli chiusi più economici. Il prezzo medio per milione di token è sceso del 41% dal picco di marzo, a 0,68 dollari. Per ora, insomma, a guadagnarci sono soprattutto i prezzi.
Il rischio vero è il fornitore
Revolut parla di costi e di priorità all’open source, non di lock-in. Ma l’effetto pratico è lo stesso: avere un’alternativa già in casa. Quando una tecnologia diventa core, ogni scelta del fornitore (prezzo, modello, regole d’uso, limiti) diventa una scelta anche vostra, senza che l’abbiate presa. Secondo un sondaggio Red Hat riportato da Agenda Digitale ad aprile, il 63% delle aziende europee ha già un piano per cambiare fornitore AI se l’accesso venisse limitato all’improvviso.
Il nodo che resta è la provenienza: GLM è un modello cinese. Abitbol sostiene che il rischio sta nel chiamare API ospitate fuori dalla Cina, e che con l’installazione su server propri o in un cloud regionale sia basso. È la sua valutazione, e in Europa farà discutere. Non servono per forza modelli cinesi, comunque: anche Mistral pubblica modelli open-weight installabili in autonomia.
Quando conviene davvero
In sintesi, il self-hosting paga quando i volumi sono alti, i carichi prevedibili e c’è un team che lo sappia mettere a punto. Sotto quella soglia la via di mezzo è più sensata: un router, modelli aperti via API per il lavoro di tutti i giorni e il modello di frontiera riservato ai compiti difficili.
Domande frequenti
Che cos’è l’AI self-hosted?
Sono modelli con pesi aperti (open-weight) installati su server propri o in un cloud dedicato, invece di chiamare l’API di un fornitore. Prompt e dati restano in azienda e il costo dipende dall’hardware, non dai token.
Quanto risparmia davvero Revolut?
Dichiara circa il 90%, 0,30 dollari per milione di token. Un’analisi esterna, tenendo conto della cache dei prompt, stima un vantaggio tra 1,5 e 3 volte rispetto a Sonnet e Opus, e il costo dell’hardware non è pubblico.
Considerazioni finali
Io non lo leggo come una condanna di Claude o di OpenAI: i modelli di frontiera restano, per ora, un gradino sopra su molti compiti. La lezione è un’altra: non fatevi trovare senza alternativa. Chi ha già provato un modello aperto, chi ha un router e un piano B ha in mano una leva di trattativa, oltre che un risparmio. Gli altri, ahimè, il prezzo lo accetteranno e basta.
Fonti
- British fintech Revolut slashes AI coding costs 10x by cutting out Claude and going self-hosted, The Register, 3 novembre 2026
- Revolut Self-Hosted GLM for 2,000 Engineers… The 10x Savings Need a Footnote, BuildMVPFast (analisi di terzi, stime non verificate da Revolut)
- Revolut says self-hosted AI cut coding costs 90%, StartupHub.ai; Analytics India Magazine
- Enterprises Embrace Open Weights but Infrastructure Sellers Profit Most, Futurum, 26 ottobre 2026
- US Companies Turn to Open Models as AI Bills Climb, NYU Shanghai RITS (sintesi di Financial Times, ETR e Ramp)
- AT&T open telco update, AMD, 23 luglio 2026
- Sovranità e AI: cosa ne pensano i decisori aziendali, Agenda Digitale (report Red Hat), 30 aprile 2026